Choisissez vos modèles d’IA usage par usage, sur des essais mesurés
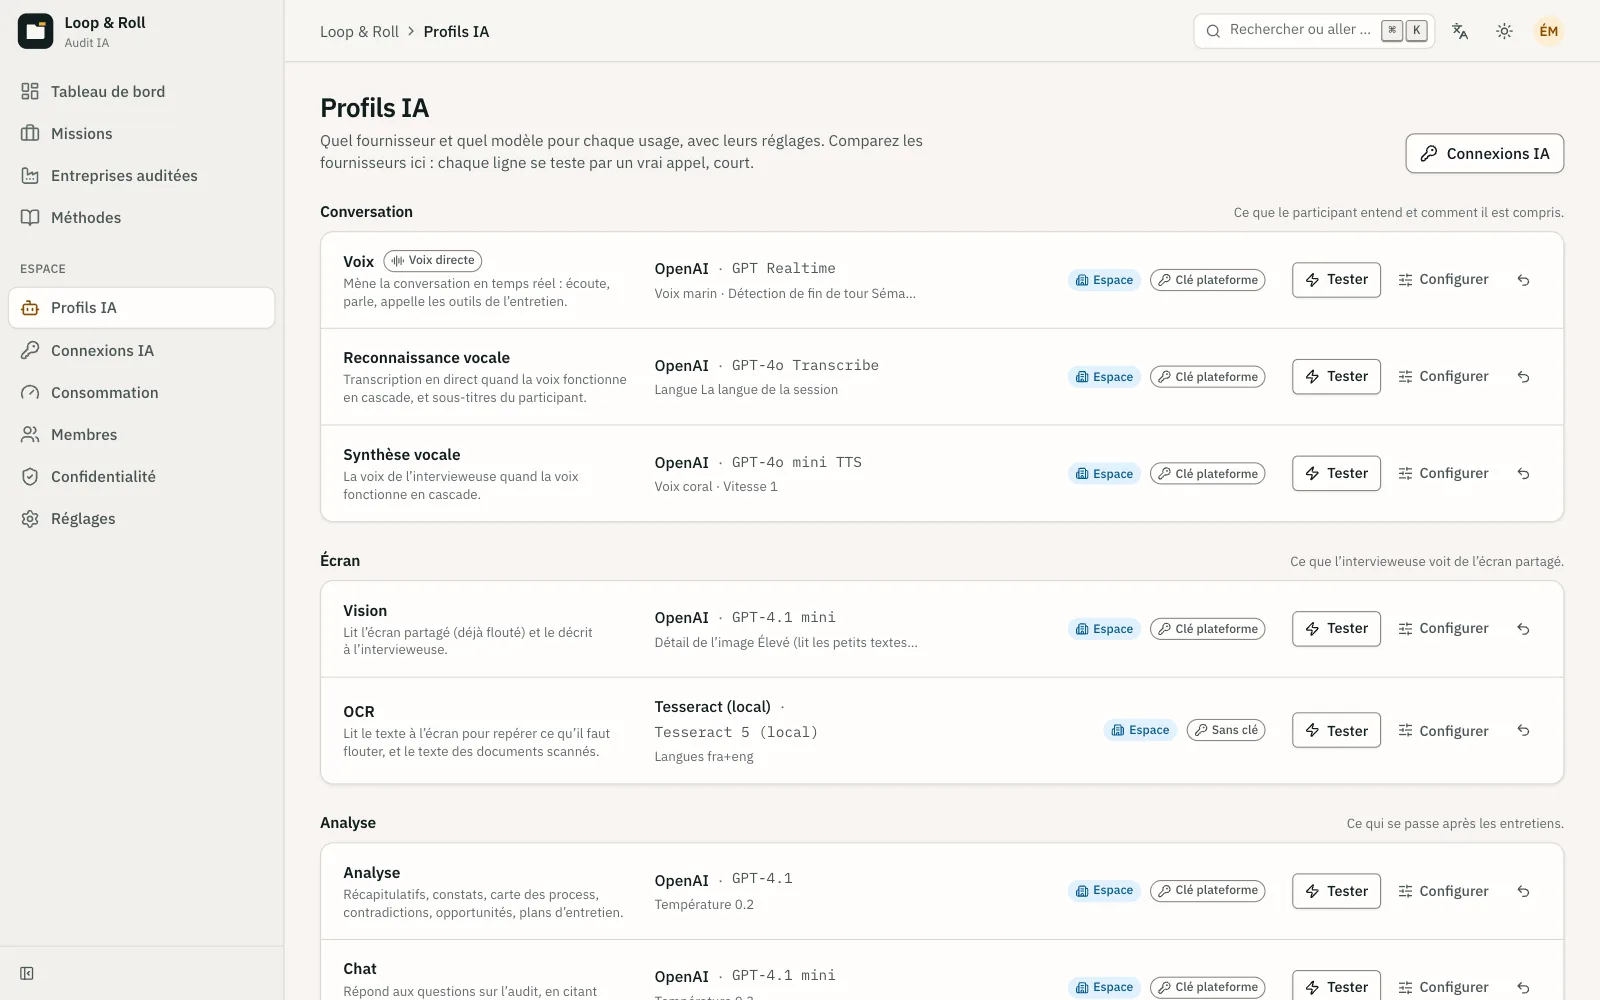
Voix, transcription, vision, analyse, chat et recherche se configurent séparément. Le Labo voix vous fait parler avec chaque configuration et mesure latence et coût avant que vous l’employiez en mission.
- 6 usages IA configurables séparément
- Deux architectures voix : voix directe, ou chaîne transcription, modèle, synthèse
- Clés du cabinet chiffrées, jamais affichées
Le point de départ
Un outil lié à un seul modèle
Les modèles de voix et de langage changent tous les trimestres, leurs prix aussi. Un outil qui impose son fournisseur impose aussi sa qualité en français, sa latence, son lieu de traitement et sa facture. Le cabinet n’a aucun moyen de comparer, encore moins de changer.
Six usages, six réglages
Conduire la conversation, transcrire, lire l’écran, analyser, répondre dans le chat et chercher dans l’audit n’ont pas les mêmes contraintes. La voix exige une latence faible, l’analyse un raisonnement sur un long contexte, la vision un coût par image maîtrisé. Chaque usage a donc son fournisseur, son modèle et ses réglages.
- Profils définis pour l’espace, surchargeables par méthode puis par mission.
- Profils par défaut fournis, tous modifiables.
- Un bouton « tester » sur chaque profil, qui affiche la latence et le coût de l’essai.
- Vision séparée de la voix par défaut, pour que chaque lecture d’écran soit stockée et vérifiable.
Deux façons de faire parler l’intervieweuse
En voix directe, un seul modèle écoute et parle : la latence est la plus faible et les interruptions sont gérées nativement. En chaîne, la parole est transcrite, un modèle de langage de votre choix répond, puis une synthèse vocale parle : chaque brique est interchangeable, pour une latence un peu plus élevée. Le reste du produit ne voit pas la différence.
- Voix directe : OpenAI Realtime.
- Chaîne : transcription OpenAI ou Deepgram, modèle de langage OpenAI ou compatible OpenAI, synthèse OpenAI ou ElevenLabs.
- Dans les deux cas, l’intervieweuse dispose des mêmes outils : couverture des thèmes, lecture de l’écran, épingles.
Le Labo voix, pour choisir sur pièces
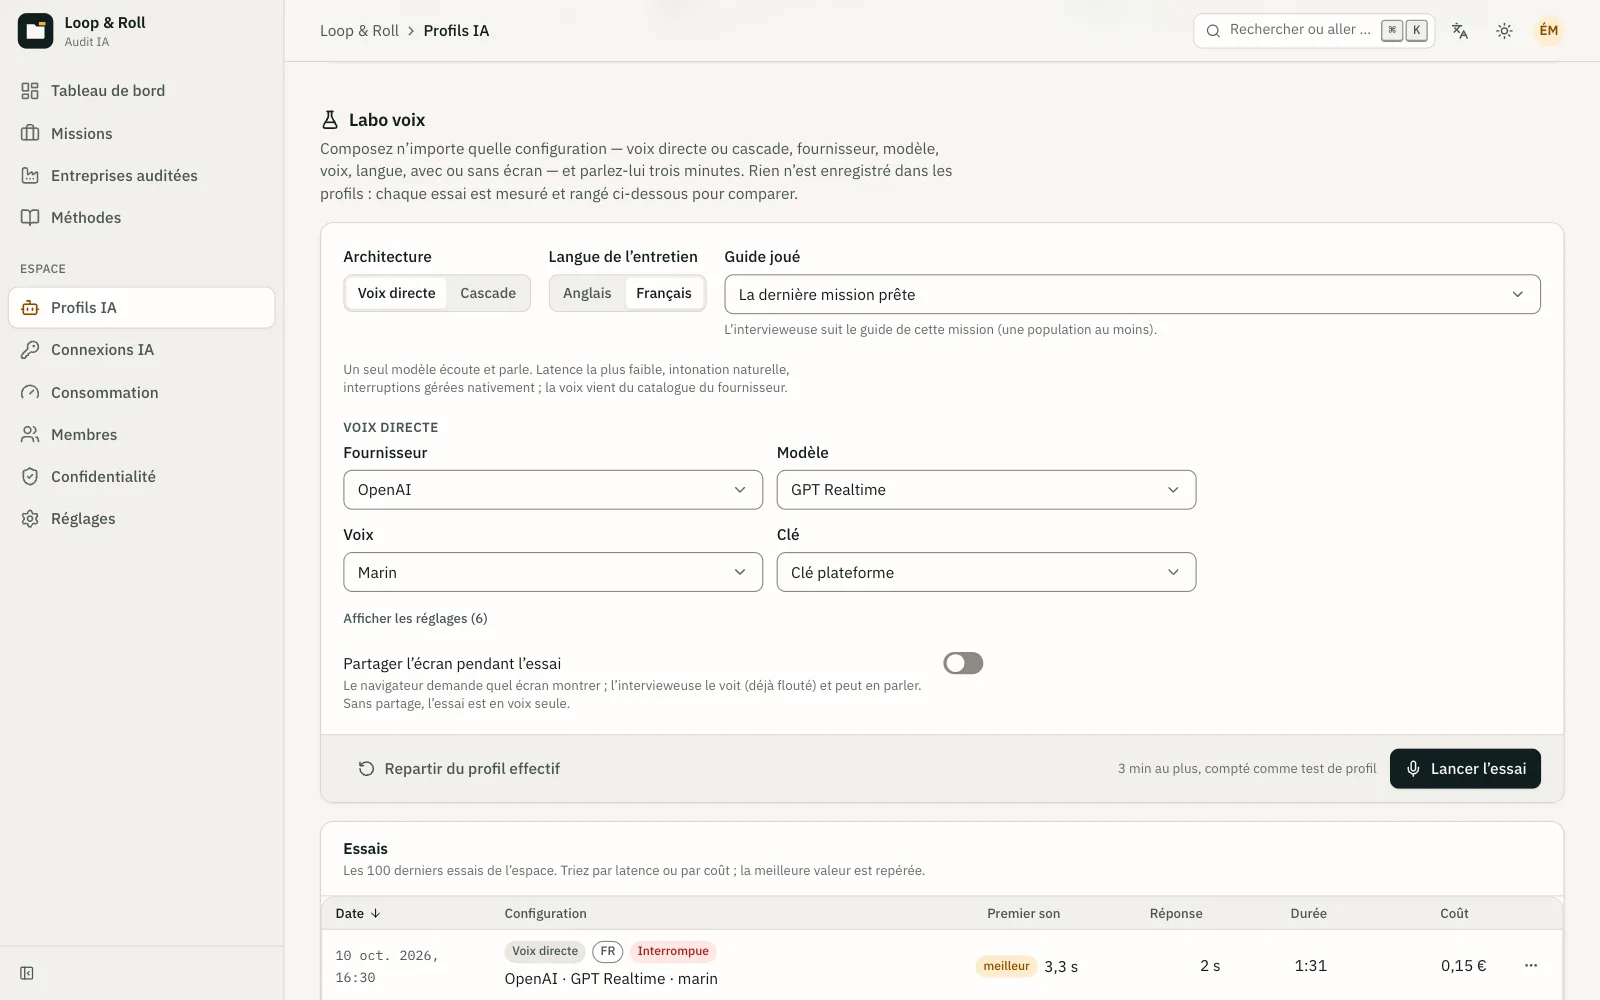
Le Labo voix compose n’importe quelle configuration : voix directe ou chaîne, fournisseur, modèle et voix de chaque brique, langue, avec ou sans partage d’écran. Vous parlez trois minutes avec elle, sur le guide d’une de vos missions. Le délai jusqu’au premier son, le délai de réponse moyen et le coût sont mesurés, puis rangés dans l’historique des essais.
- Historique trié, avec la meilleure valeur repérée et vos notes sur chaque essai.
- Une configuration déjà essayée se relance telle quelle pour comparer.
- Les essais sont présentés à part des missions dans le suivi des coûts.
Clés, sécurité et souveraineté
Le cabinet utilise ses propres clés, vérifiées puis chiffrées et jamais affichées, ou celles de la plateforme si son offre le prévoit. Pour l’analyse, le chat et la recherche, il peut retenir des options européennes : Mistral, ou des modèles auto-hébergés derrière une interface compatible OpenAI. La lecture du texte des écrans, qui précède le floutage, tourne sur nos serveurs.
- Ce que dit le participant et ce qui est à l’écran sont traités comme des données, jamais comme des instructions.
- Les kits de conformité listent comme sous-traitants les fournisseurs réellement configurés.
En pratique
- Usages
- Voix, transcription, vision, analyse, chat, recherche dans l’audit ; la chaîne vocale ajoute un profil de transcription en direct et un profil de synthèse vocale.
- Fournisseurs
- OpenAI (par défaut), Mistral, Deepgram, ElevenLabs, et tout service compatible OpenAI (OpenRouter, Ollama, vLLM…), selon l’usage.
- Lecture de texte (OCR)
- Un moteur exécuté sur nos serveurs pour le floutage ; pour le texte des pièces, le moteur de votre choix, par exemple Mistral OCR.
- Niveaux de configuration
- Espace, puis méthode, puis mission ; l’écran affiche pour chaque usage le profil effectif et sa provenance.
- Clés
- Vérifiées en ligne avant enregistrement, chiffrées au repos, jamais affichées ni journalisées.
- Labo voix
- Essais de trois minutes en conversation réelle, réservés aux admins de l’espace, avec latence et coût mesurés.
- Langues de session
- Français et anglais.
Questions fréquentes
Pouvons-nous utiliser nos propres clés d’API ?
Oui. Un cabinet enregistre dans TellMeHow ses propres clés, fournisseur par fournisseur : elles sont vérifiées, chiffrées, puis plus jamais affichées. Il peut aussi utiliser les clés de la plateforme si son offre le prévoit. Le suivi des coûts indique, pour chaque appel, quelle clé a été utilisée.
Quelle différence entre voix directe et chaîne ?
En voix directe, un seul modèle écoute et répond à voix haute, ce qui donne la latence la plus faible et une gestion native des interruptions. En chaîne, la transcription, le modèle de langage et la synthèse vocale sont trois briques choisies séparément, ce qui permet par exemple de prendre la meilleure voix française et le modèle de son choix. TellMeHow prend en charge les deux, et le Labo voix permet de les comparer.
Pourquoi la vision est-elle séparée de la voix par défaut ?
Des erreurs de lecture d’écran sont rapportées avec les modèles de voix directe qui reçoivent eux-mêmes les images. TellMeHow confie donc par défaut l’écran à un modèle de vision dédié, dont chaque description est conservée. Une lecture d’écran devient ainsi vérifiable et peut servir de preuve.
Peut-on s’en tenir à des fournisseurs européens ?
En partie, selon l’usage. Dans TellMeHow, l’analyse, le chat et la recherche peuvent passer par Mistral ou par des modèles auto-hébergés compatibles OpenAI, et la lecture du texte des écrans pour le floutage tourne sur nos serveurs. La conversation vocale en temps réel s’appuie aujourd’hui sur OpenAI, avec Deepgram ou ElevenLabs en option, des fournisseurs qui peuvent traiter les données aux États-Unis : vérifiez leurs conditions de traitement.
Comment choisir les modèles pour une mission ?
Le Labo voix de TellMeHow permet de parler trois minutes avec une configuration, sur le guide d’une vraie mission, et en mesure la latence et le coût. Les essais sont conservés et comparables, ce qui permet de choisir sur des chiffres plutôt que sur une impression. La configuration retenue s’applique ensuite à l’espace, à une méthode ou à une seule mission.
Fonctionnalités liées
- Suivi des coûts La consommation d’IA de chaque mission, visible au fil de l’eau, avec plafonds et alertes.
- Entretiens vocaux Chaque collaborateur parle à l’intervieweuse quand il veut, depuis son navigateur, en plusieurs fois.
- Confidentialité et RGPD Des process, jamais des personnes : floutage, conservation limitée, kits CSE et AIPD fournis.
Voyez un audit complet en trente minutes.
Un entretien vocal avec partage d’écran, la carte des process qui en sort, le livrable que lit le sponsor : sur une mission de démonstration, avec vos questions.